November 20-tól a Meta a belépés mögé is benézhet. Így zárhatod ki a robotjait.
November 20-tól a Meta saját hozzáférést hozhat létre a weboldaladon. Három technikai megoldás, amellyel kizárhatod a robotjait: robots.txt, szerveroldali tiltás és a regisztráció védelme.
November 20-tól a Meta saját hozzáférést hozhat létre a weboldaladon. Az engedélyt te adod meg neki, aláírás nélkül: elég, ha van céges Facebook-oldalad vagy Instagram-fiókod.
Robotok eddig is olvasták a weboldalak nyilvános részét. Az új az, hogy a Meta feltételei már a belépés mögé is utat nyitnak: az ügyfélportálra, az online tanfolyamra, a tagsági oldalra. Ez a cikk végigveszi, mit enged a feltétel, és azt a három technikai megoldást, amellyel szűkítheted, mit olvashatnak a Meta robotjai.
Mit enged pontosan a Meta új feltétele?
A Meta üzleti felhasználási feltételeinek (Commercial Terms) új változata 2026. november 20-án lép hatályba. Aki ezután is üzleti célra használja a Facebookot vagy az Instagramot, elfogadja. A beszámolók szerint kilépési lehetőség nincs, csak az, hogy abbahagyod a Meta termékeinek üzleti használatát.
Az új bekezdés szerint a Meta, vagy bárki, aki a nevében eljár, „automatizált szoftvereket (például webes adatgyűjtő programokat, botokat, robotokat, spider programokat, keresőrobotokat és felhasználói ügynököket)” használhat a vállalkozásodhoz tartozó tartományok, weboldalak és URL-címek eléréséhez, indexálásához, gyorsítótárazásához és begyűjtéséhez. A Meta ehhez „tesztelési célú hozzáférési adatokat” is létrehozhat.
Hogy mi a tesztelési célú hozzáférési adat, azt a feltételek nem határozzák meg. James Grimmelmann, a Cornell Egyetem jogászprofesszora a Nieman Lab szaklapnak azt mondta: a szöveg alapján a Meta álfelhasználóként regisztrálhat egy oldalon, hogy átjusson a regisztrációs falon. Arra a kérdésre, hogy ez a fizetős tartalomra is vonatkozik-e, a Meta nem válaszolt.
A Meta szóvivője, Andy Stone szerint a hírek tévesek: a Meta nem változtat azon, ahogyan a robotjait használja, és a weboldalak gazdái továbbra is a robots.txt fájllal szabályozhatják, mit olvasnak.
A dátum egyszer már változott: eredetileg október 30. volt, a Meta október 23-án halasztotta november 20-ra. A szöveg nem változott.
Miért számít, mi van a belépés mögött?
Mert a feltétel szerint a Meta a begyűjtött tartalmat a hirdetési és üzleti termékei „fejlesztésére, továbbfejlesztésére és kutatására” használhatja.
A beszámolók szerint a feltétel első változatában az állt, hogy a tartalommal a Meta a termékeit „tanítja”. A kiadók tiltakozása után ez a szó kikerült, a „fejlesztés” bent maradt. A jogászok szerint a fejlesztés a mesterséges intelligencia tanítását is fedheti. A Meta saját robotleírása pedig kimondja, hogy egyik robotja, a meta-externalagent, többek között MI-alapmodellek tanításához gyűjt.
Ami a regisztráció mögött van, az jellemzően az értékesebb szakmai tartalmad: a fizetős tananyag, az ügyfeleknek szóló útmutató, a tagoknak írt elemzés. Ez az a tudás, amiből minden cég él.
Van egy kevésbé látható következmény is. Ha egy robot regisztrál, a te számaidban új regisztrációként vagy új érdeklődőként jelenik meg. Egy svájci induló cégnél, ahol dolgoztam, a fejlesztők próbálgatták a regisztrációt, és a mérés mindegyiküket valódi látogatónak számolta. A riportból így a csapat viselkedése látszott, nem a vevőké. Egy idegen tesztfiók ugyanígy torzítja a számot, csak róla nem is tudsz.
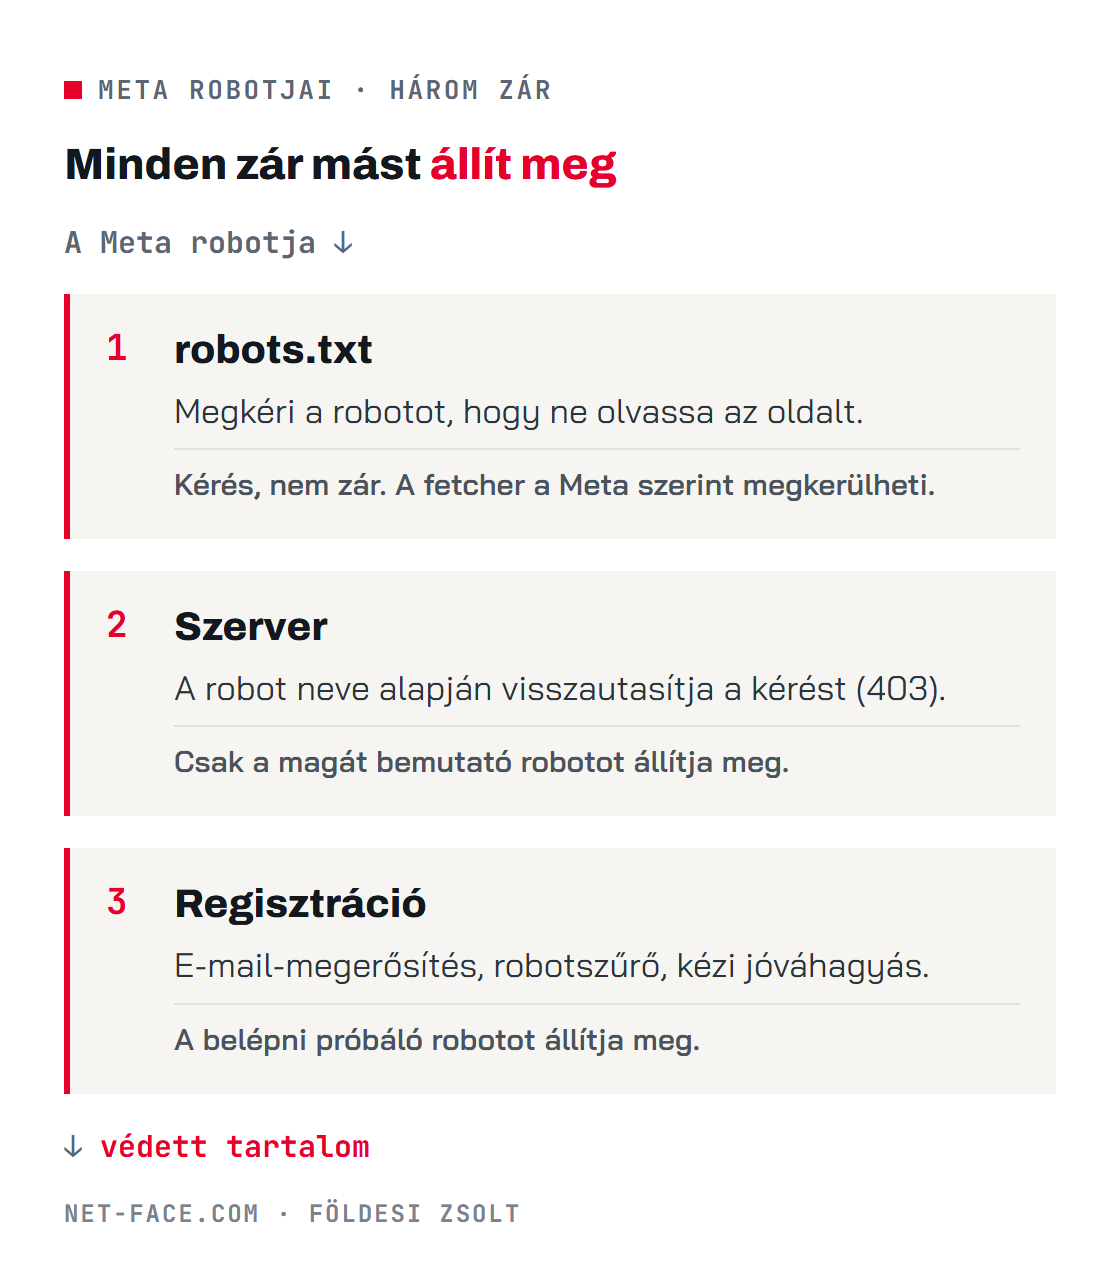
A következő három rész egy-egy zárat mutat be. Mindegyik mást állít meg, ezért ahol értékes tartalom van a belépés mögött, ott mind a három kell.
Első zár: mit tilthatsz le a robots.txt fájlban?
A robots.txt egy kis szövegfájl a weboldalad gyökerében (például pelda.hu/robots.txt), amely megmondja a robotoknak, hová mehetnek. A Meta öt robotot nevez meg a saját leírásában. Nem mindegyiket érdemes tiltani:
| Robot | Mire való a Meta szerint | Tiltsd? | Betartja a tiltást? |
|---|---|---|---|
| meta-externalagent | Többek között MI-alapmodellek tanítása | Igen, ha nem akarod, hogy a tartalmad ehhez kerüljön | A Meta szerint igen |
| meta-externalfetcher | Egy-egy link lekérése, ha egy felhasználó kéri (például a Meta AI-tól) | A belépés mögötti részen igen; a nyilvános oldalakon a te döntésed | A Meta szerint megkerülheti |
| meta-externalads | Hirdetési termékek fejlesztése | A te döntésed | A leírás nem mondja, hogy megkerülné |
| meta-webindexer | A Meta AI keresési találatai | Csak ha nem baj, hogy a Meta AI nem hivatkozik rád | A leírás nem mondja, hogy megkerülné |
| facebookexternalhit | A megosztott link előnézete (cím, leírás, kép) | Nem: e nélkül a Facebookon megosztott linkjeidnek nincs képe | Biztonsági ellenőrzésnél megkerülheti |
A két fő robot tiltása, a robots.txt fájl végére másolva:
User-agent: meta-externalagent Disallow: / User-agent: meta-externalfetcher Disallow: /A facebookexternalhit robotra ne írj tiltást.
A teljes oldalra vagy csak egy részére? A fenti példa, és a cikk további példái is, a teljes weboldalra vonatkoznak: a / az oldal minden címét jelenti. Ha csak a jelszóval védett részt akarod lezárni, és az külön címen érhető el (például /tanfolyam/ vagy /fiokom/), elég a / helyére azt írni:
User-agent: meta-externalagent Disallow: /tanfolyam/ User-agent: meta-externalfetcher Disallow: /tanfolyam/Ha a védett tartalom nem külön címen van, hanem ugyanazon az oldalon jelenik meg belépés után, akkor részleges tiltás nem lehetséges, csak a teljes oldalé, vagy a harmadik zár.
Mire nem jó a robots.txt: kérés, nem zár. A jól nevelt robotok betartják, de semmi nem kényszeríti őket. A Meta maga írja, hogy a meta-externalfetcher megkerülheti, mert felhasználói kérésre dolgozik. A robotok a fájlt akár 24 óráig is gyorsítótárban tarthatják, ezért egy változás nem azonnal hat.
A robots.txt tehát az első lépés, nem a legerősebb.
Második zár: hogyan tiltod le a robotokat a szerveren?
A szerveroldali tiltás nem kéri a robotot, hanem visszautasítja: a robot a lap helyett egy 403-as hibaüzenetet kap („hozzáférés megtagadva”). A szerver a kérés fejlécéből, a felhasználói ügynökből (user agent) ismeri fel, ki kopogtat.
Ha az oldalad Cloudflare mögött fut: a Security menü WAF részében hozz létre egy egyéni szabályt (Custom rule) ezzel a feltétellel, „Block” művelettel:
(http.user_agent contains "meta-externalagent") or (http.user_agent contains "meta-externalfetcher")A Cloudflare-nek ezen felül van egy kapcsolója az ismert MI-robotok egyben tiltására is. Ez kényelmes, de nem csak a Metát zárja ki.
Ha saját szerveren fut (Apache): a fejlesztőd ezt a .htaccess fájlba teszi:
RewriteEngine On RewriteCond %{HTTP_USER_AGENT} (meta-externalagent|meta-externalfetcher) [NC] RewriteRule .* - [F,L]Nginx szerveren a szerver beállításai közé:
if ($http_user_agent ~* "(meta-externalagent|meta-externalfetcher)") { return 403; }Csak a védett részre a szabályokba bekerül a cím is (itt /tanfolyam/):
Cloudflare: (http.user_agent contains "meta-externalagent" or http.user_agent contains "meta-externalfetcher") and starts_with(http.request.uri.path, "/tanfolyam/") Apache (.htaccess), a RewriteRule elé egy sorral: RewriteCond %{REQUEST_URI} ^/tanfolyam/ Nginx, a tiltás a védett rész blokkjába kerül: location /tanfolyam/ { if ($http_user_agent ~* "(meta-externalagent|meta-externalfetcher)") { return 403; } }Nginx-nél a meglévő location /tanfolyam/ blokkba kerüljön, ha van ilyen, különben a védett rész többi beállítása elveszhet. Ezt a fejlesztőd tudja megnézni.
WordPress: több bővítmény tiltja egy kattintással a mesterséges intelligencia robotjait. Mielőtt bekapcsolod, nézd meg a listáját. Egy ilyen bővítmény azokat a robotokat is kizárhatja, amelyek alapján a ChatGPT vagy a Perplexity megtalálja és ajánlhatja a cégedet.
A határa: a szerver csak azt a robotot ismeri fel, amelyik bemutatkozik. Egy közönséges böngészőnek álcázott robot átmegy rajta. A Meta a robotleírásában nem ad közre ellenőrizhető IP-címlistát, így a tiltás a nevükre épül.
Mit veszítesz, ha az egész oldalt tiltod?
A Metának van nyilvános mesterségesintelligencia-szolgáltatása: a Meta AI asszisztens a WhatsAppban, a Messengerben, az Instagramon, a Facebookon és külön alkalmazásként is elérhető, és keresni is tud a weben. A Meta robotleírása szerint ha engedi a meta-webindexer robotot, az segít, hogy a Meta AI hivatkozzon a tartalmadra és linkeljen rá. A meta-externalfetcher pedig akkor olvassa el az oldaladat, amikor egy felhasználó a Meta AI-tól kérdez róla.
Ha a teljes oldalról kitiltod ezeket a robotokat, a Meta AI a válaszaiban kevésbé tud rád hivatkozni, és a cégedet sem tudja ajánlani abból, amit az oldaladon írsz. Ugyanúgy, ahogy egy keresőből is kimaradna az az oldal, amelyiket a keresőrobot nem olvashat.
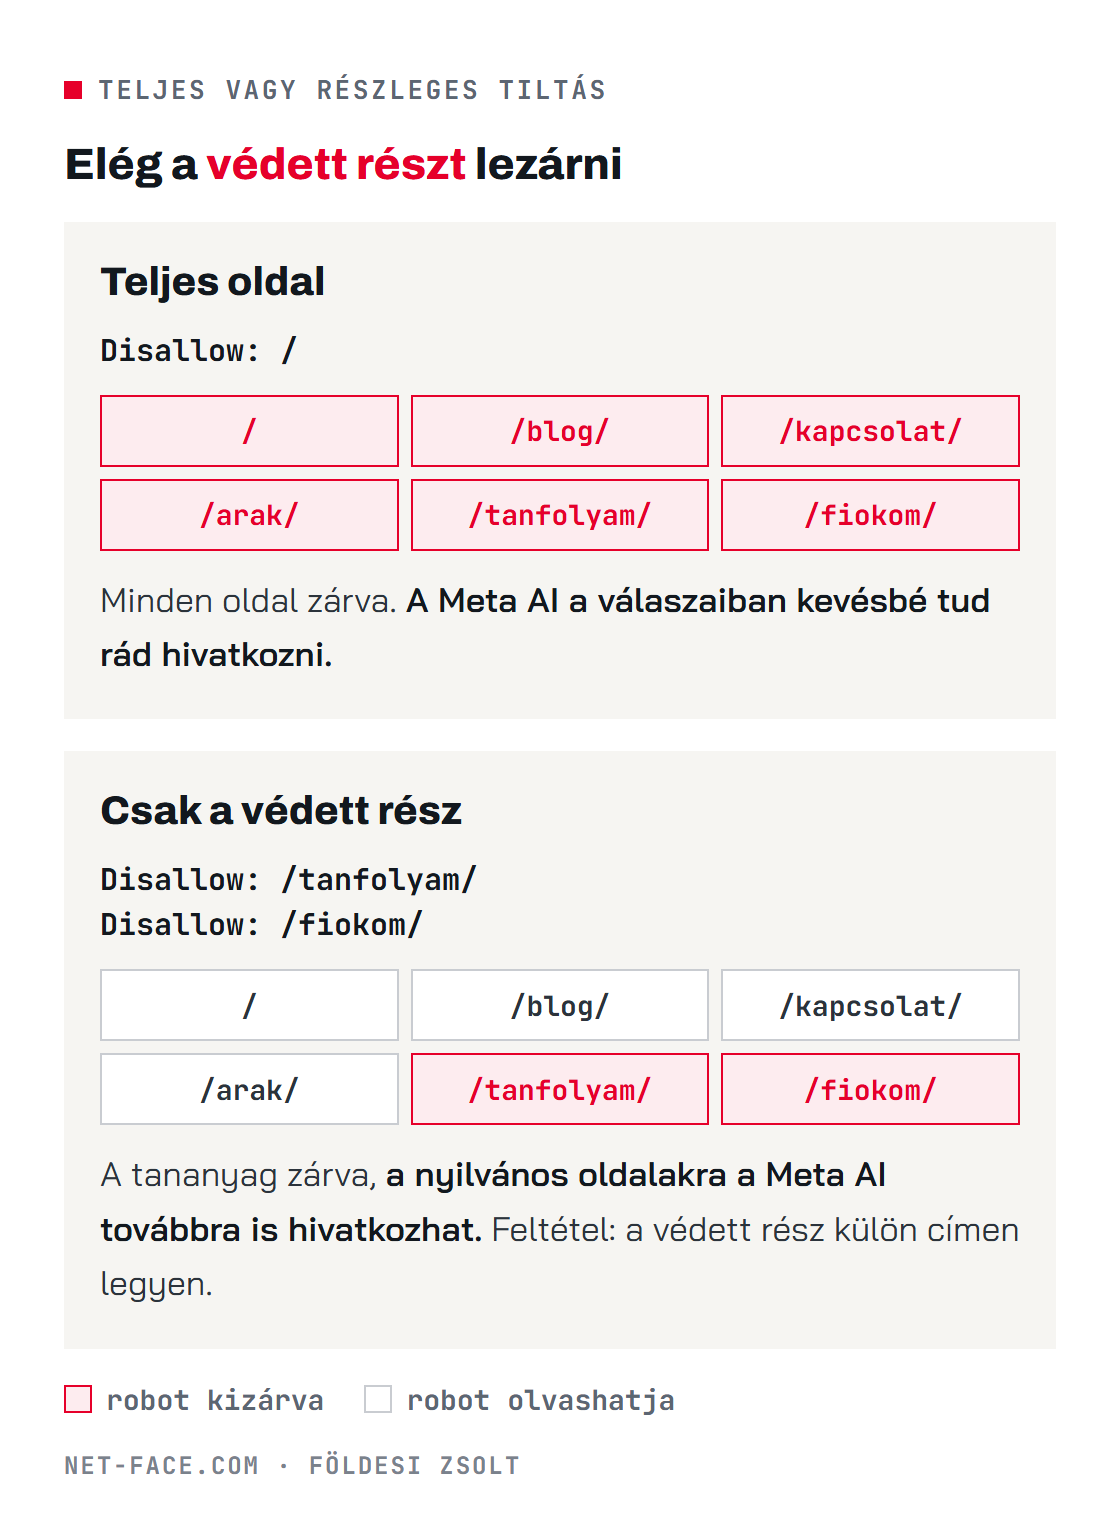
Ezért a legtöbb vállalkozásnak a részleges tiltás a jobb: a belépés mögötti tartalmat lezárod, a nyilvános oldalakon pedig eldöntöd, mit engedsz. A meta-externalagent robotot, amely a Meta szerint MI-modellek tanításához gyűjt, a teljes oldalról is tilthatod úgy, hogy a Meta AI keresőjét kiszolgáló meta-webindexer szabad marad.
Harmadik zár: hogyan véded magát a regisztrációt?
Ha egy robot fiókot nyit és belép, a robots.txt és a névalapú tiltás már nem számít. Ezért a regisztrációnak magának kell nehezen átjárhatónak lennie:
- E-mail-megerősítés: a fiók csak akkor él, ha valaki rákattint a megerősítő levélre.
- Robotszűrő a regisztrációs űrlapon: például Cloudflare Turnstile vagy Google reCAPTCHA.
- Kézi jóváhagyás vagy fizetés ott, ahol a tartalom igazán értékes: tanfolyam, ügyfélportál, zárt csoport.
- A meglévő fiókok átnézése: furcsa e-mail-címek, üres profilok, rövid idő alatt sok új fiók. Ezek a jelek.
Érdemes a saját felhasználási feltételeidben is kimondani, hogy gépi úton létrehozott fiók és automatikus adatgyűjtés nem megengedett. Hogy ez a Meta feltételeivel szemben mit ér, az jogi kérdés, és nem tudok rá választ adni.
Mit tegyél, ha az oldalad nem a saját szervereden fut?
Bérelt platformon a robots.txt és a tűzfal a szolgáltató kezében van, vagy csak részben a tiédben.
- Shopify: a robots.txt a téma robots.txt.liquid sablonjában szerkeszthető.
- Wix: a robots.txt a SEO-beállítások között szerkeszthető.
- Tanfolyam- és tagsági platformok: platformonként eltér. Kérdezd meg a szolgáltatót, hogy tiltja-e a meta-externalagent és a meta-externalfetcher robotot, és hogyan védi a regisztrációt a gépi fiókoktól.
Hogyan ellenőrizheted, hogy a tiltás működik?
Elkészítettem egy ingyenes, automatikus ellenőrzőt: Meta robot ellenőrző. Beírod a domainedet, és két dolgot néz meg:
- Mit enged a robots.txt a Meta öt robotjának egyenként, és hogy a facebookexternalhit szabadon maradt-e.
- Mit válaszol a szervered, ha a Meta robotjainak nevével kérünk le egy oldalt: beengedi, vagy visszautasítja.
Amit nem tud megnézni: hogy a Meta valóban betartja-e a tiltást. Ezt kívülről senki nem tudja ellenőrizni. Az ellenőrző azt mutatja meg, hogy a te oldaladon minden szabály a helyén van-e.
Segítség kell a szabályok értelmezéséhez?
Maxiumum 10 jelentkezőnek, aki november 10-ig jelentkezik, ingyen adok tanácsot 15 percben: mit jelent a feltétel a te oldaladra, melyik zár kell neked, és milyen lépéseket tudsz tenni a tartalmad megvédéséhez. Jelentkezés: https://net-face.com/hu/main-magyar/#contact.
Gyakori kérdések
Elég a robots.txt? Annak a robotnak elég, amelyik betartja. A Meta szerint a meta-externalagent betartja, a meta-externalfetcher megkerülheti. Ahol a belépés mögött értékes tartalom van, ott a szerveroldali tiltás és a regisztráció védelme is kell.
Ha tiltom a Meta robotjait, eltűnik a linkjeim előnézete a Facebookon? Nem, ha a facebookexternalhit robotot szabadon hagyod. A fenti szabályok ezt nem érintik.
Kevesebb látogatót hoz a Facebook, ha tiltom a robotokat? A link-előnézet és a hirdetések működnek tovább, ha a facebookexternalhit szabad. Ha a meta-webindexer vagy a meta-externalfetcher robotot a teljes oldalról tiltod, a Meta AI válaszaiban kevésbé jelensz meg forrásként. Ha csak a belépés mögötti részt zárod le, ez nem érint.
Mi van, ha az oldalamon nincs belépés? Akkor a regisztrációs rész nem érint. A nyilvános tartalmadat robotok eddig is olvashatták; a robots.txt-vel eldöntheted, hogy a Meta MI-tanításra gyűjtő robotja olvassa-e.
Kötelező elfogadnom a feltételt? A beszámolók szerint nem lehet kilépni belőle úgy, hogy közben üzleti célra használod a Facebookot vagy az Instagramot. Ez nem jogi tanács: ha a feltétel a cégedet érinti, kérdezz jogászt.
Források: a Meta üzleti felhasználási feltételeinek előzetes szövege (facebook.com/legal/commercial_terms_preview, magyar, brit és amerikai változat, 2026. október 23-án olvasva); a Meta robotleírása (developers.facebook.com/docs/sharing/webmasters/web-crawlers); Nieman Lab, 2026. október 15., és a róla szóló szaksajtó (PPC Land, Media Copilot).